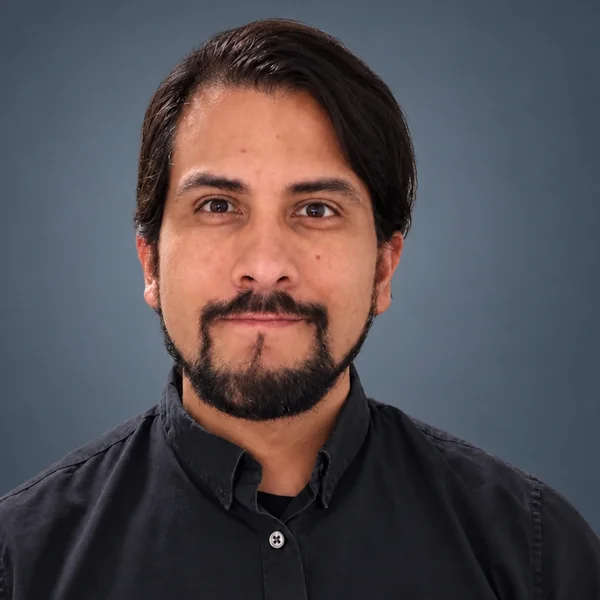
Sobre mí
Ingeniero de datos. Construyo pipelines testeados, monitorizados y pensados para durar.
Soy ingeniero de datos con más de seis años de experiencia diseñando y operando pipelines de integración de datos para empresas de finanzas, seguros, movilidad y marketing, primero como consultor en Epsilon France (Publicis Groupe) y después como ingeniero de datos en RiverBank y Corum L'Épargne.
He trabajado en los dos mundos: procesamiento distribuido Big Data con Spark, Scala y Hadoop, y plataformas más tradicionales basadas en SQL, Azure Data Factory, Apache NiFi y Google BigQuery. En todos me centro en lo que mantiene sanos los pipelines en producción: tests automatizados, monitorización, calidad de datos y código que el siguiente ingeniero pueda mantener.
Hoy trabajo con el stack lakehouse moderno. Trabajé por primera vez con Data Vault en la plataforma de datos de Corum; mi último proyecto integra seis registros mercantiles europeos sobre Databricks y AWS con una arquitectura medallion, historial SCD tipo 2 y controles automáticos de calidad de datos, y obtuve la certificación AWS Certified Cloud Practitioner en octubre de 2026.
Cómo trabajo
- Explícito antes que implícito. Esquemas declarados en lugar de inferidos, configuración en lugar de copiar y pegar, y errores que se ven en lugar de errores silenciosos.
- Modelar para el cambio. Las fuentes cambian de formato y de datos. Separo el histórico en bruto de las reglas de negocio para que un cambio no rompa todo lo que viene después.
- Nube con conciencia de coste. Serverless donde encaja y procesamiento incremental donde compensa, como geocodificar solo las direcciones nuevas.
Experiencia
-
enero 2023 – enero 2024
Ingeniero de datos · Corum L'Épargne
Gestora internacional de inversión inmobiliaria
- Construí y mantuve pipelines ETL automatizados en Azure Data Factory para integrar datos financieros y de clientes, desde los linked services y las transformaciones hasta la orquestación.
- Desarrollé consultas SQL, procedimientos almacenados y otros objetos de base de datos para optimizar los procesos.
- Trabajé sobre una plataforma de datos modelada con Data Vault.
-
septiembre 2022 – diciembre 2022
Ingeniero de datos · RiverBank
- Trabajé en un framework para estandarizar el desarrollo de flujos de datos con PySpark.
- Implanté tests unitarios automatizados con pytest para hacer las entregas más fiables.
- Desarrollé dentro de una plataforma de datos basada en microservicios.
-
octubre 2017 – agosto 2022
Consultor Big Data · Epsilon France (Publicis Groupe)
Unidad de data marketing de Publicis Groupe
Proyectos de automatización de datos (ingesta, transformación, orquestación, monitorización y corrección de incidencias) para clientes de banca, seguros, retail y movilidad, en entornos cloud privados y públicos.
Misiones para clientes
-
Mobilize Financial Services · 2020 – 2022
Desarrollé y mantuve pipelines ETL multifuente con Apache NiFi y Python, garantizando trazabilidad e integridad, para los equipos de data science y marketing. Durante la migración a Google BigQuery, reescribí las transformaciones en SQL y concilié los resultados para que ambas plataformas produjeran datos idénticos.
-
PMU · 2020
Desarrollé pipelines Apache Spark (Scala) sobre una plataforma Hadoop para cargar datos operativos en el data lake, añadí tests automatizados para mejorar la calidad de los datos y me encargué de la monitorización, las correcciones y la orquestación.
-
Allianz France · 2017 – 2019
Modernicé procesos ETL y automaticé flujos de datos en un cloud privado, convirtiendo notebooks de Python en procesos listos para producción junto a los equipos de plataforma.
-
Certificaciones
AWS Certified Cloud PractitionerNueva
Amazon Web Services · obtenida en octubre 2026
Verificar credencialCompetencias y herramientas
- Languages
- Big Data
- Cloud & lakehouse
- Data modelling
- Orchestration
- Quality & DevOps
Formación
- Máster (M2), Datos y Conocimiento Université Paris-Saclay · Télécom ParisTech · 2016 – 2017
- Máster (M1), Ingeniería de Software Université de Rennes 1 · 2015 – 2016
- Pregrado, Ingeniería de Sistemas y Computación Universidad de los Andes, Bogotá · 2007 – 2012
Idiomas
- Español · C2
- Inglés · C1
- Francés · C1
Este sitio está escrito en los tres.
Más allá de los datos
Soy tenor y canto siempre que puedo, practico CrossFit y siento una curiosidad infinita por la naturaleza, de los ríos y bosques al fondo del océano.