Ingeniero de datos · PySpark · Databricks · AWS
Hola, soy Cato. Construyo pipelines que convierten fuentes desordenadas en tablas fiables.
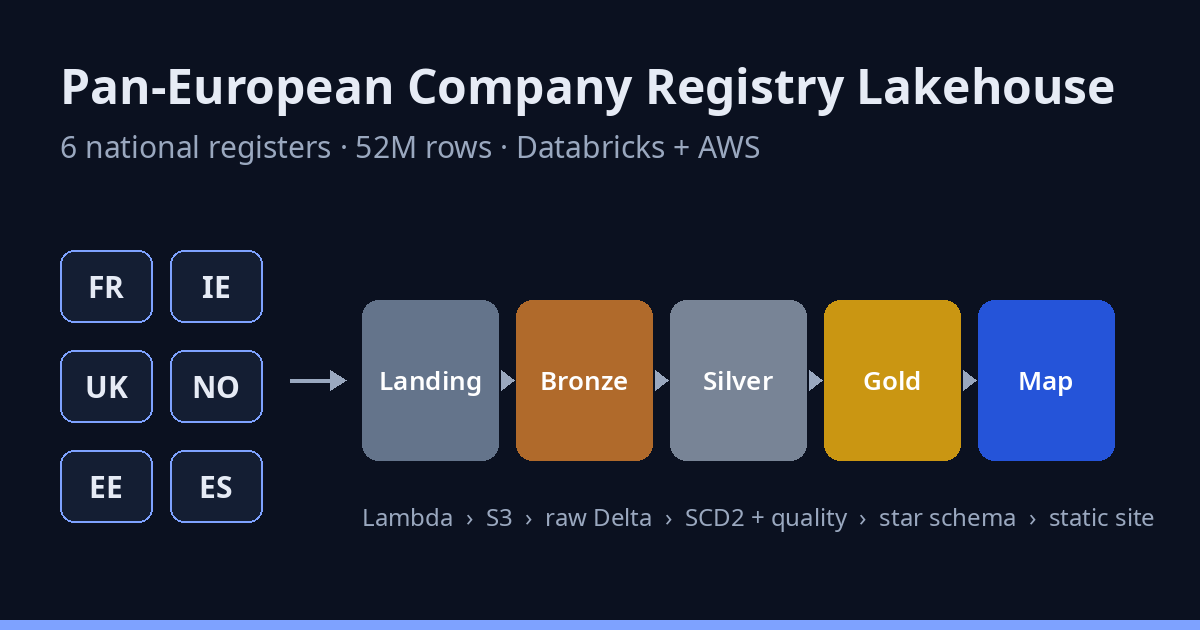
Ingeniero de datos con más de 6 años de experiencia construyendo pipelines de integración de datos para finanzas, seguros, movilidad y marketing, de Spark sobre Hadoop a Azure Data Factory y BigQuery. Mi último proyecto es un lakehouse de registros mercantiles europeos sobre Databricks y AWS: mantiene al día 52 millones de filas de registro cada mes, y sus resultados están en vivo en este sitio.
Disponible para puestos de ingeniería de datos: plantilla o freelance, en remoto o presencial en Europa.
Experiencia con
- Corum L'Épargne
- RiverBank
- Epsilon France (Publicis Groupe)
- Mobilize Financial Services
- PMU
- Allianz France