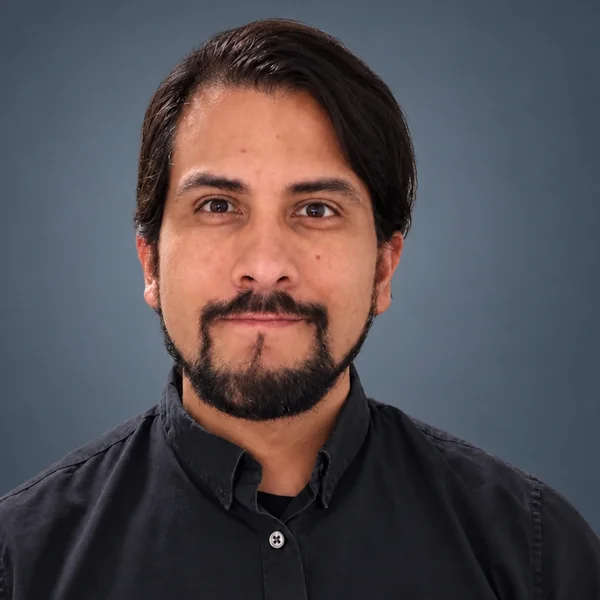
À propos
Data engineer. Je construis des pipelines testés, supervisés et faits pour durer.
Je suis data engineer avec plus de six ans d'expérience dans la conception et l'exploitation de pipelines d'intégration de données pour des entreprises de la finance, de l'assurance, de la mobilité et du marketing, d'abord comme consultant chez Epsilon France (Publicis Groupe), puis comme data engineer chez RiverBank et Corum L'Épargne.
J'ai travaillé dans les deux mondes : le traitement distribué Big Data avec Spark, Scala et Hadoop, et des plateformes plus classiques reposant sur SQL, Azure Data Factory, Apache NiFi et Google BigQuery. Partout, je me concentre sur ce qui garde les pipelines en bonne santé en production : tests automatisés, supervision, qualité des données et un code que le prochain ingénieur pourra maintenir.
Aujourd'hui je travaille sur la stack lakehouse moderne. J'ai découvert Data Vault sur la plateforme de données de Corum ; mon dernier projet intègre six registres d'entreprises européens sur Databricks et AWS avec une architecture médaillon, un historique SCD de type 2 et des contrôles automatiques de qualité des données, et j'ai obtenu la certification AWS Certified Cloud Practitioner en octobre 2026.
Ma façon de travailler
- L'explicite avant l'implicite. Des schémas déclarés plutôt qu'inférés, de la configuration plutôt que du copier-coller, et des erreurs visibles plutôt que silencieuses.
- Modéliser pour le changement. Les sources changent de format et de contenu. Je sépare l'historique brut des règles métier pour qu'un changement ne casse pas toute la chaîne en aval.
- Un cloud attentif aux coûts. Du serverless quand c'est pertinent, et de l'incrémental quand c'est rentable, comme ne géocoder que les nouvelles adresses.
Expérience
-
janvier 2023 – janvier 2024
Data Engineer · Corum L'Épargne
Société internationale d'épargne immobilière
- Conception et maintenance de pipelines ETL automatisés sous Azure Data Factory intégrant les données financières et clients, des linked services et transformations jusqu'à l'orchestration.
- Écriture de requêtes SQL, de procédures stockées et d'autres objets de base de données pour optimiser les traitements.
- Développements sur une plateforme de données modélisée en Data Vault.
-
septembre 2022 – décembre 2022
Data Engineer · RiverBank
- Travail sur un framework standardisant le développement des flux de données PySpark.
- Mise en place de tests unitaires automatisés avec pytest pour fiabiliser les livraisons.
- Développements au sein d'une plateforme de données en architecture microservices.
-
octobre 2017 – août 2022
Consultant Big Data · Epsilon France (Publicis Groupe)
Entité data marketing de Publicis Groupe
Projets d'automatisation des données (ingestion, transformation, orchestration, supervision et correction d'anomalies) pour des clients de la banque, de l'assurance, du retail et de la mobilité, sur des clouds privés et publics.
Missions clients
-
Mobilize Financial Services · 2020 – 2022
Développement et maintenance de pipelines ETL multi-sources avec Apache NiFi et Python, garantissant traçabilité et intégrité, pour les équipes data science et marketing. Lors de la migration vers Google BigQuery, réécriture des transformations en SQL et rapprochement des résultats pour garantir des données identiques sur les deux plateformes.
-
PMU · 2020
Développement de pipelines Apache Spark (Scala) sur une plateforme Hadoop pour intégrer les données opérationnelles au data lake, ajout de tests automatisés pour la qualité des données, supervision, corrections et orchestration des flux.
-
Allianz France · 2017 – 2019
Modernisation des processus ETL et automatisation des flux de données sur un cloud privé, avec l'industrialisation de notebooks Python en traitements de production, en lien avec les équipes plateforme.
-
Certifications
AWS Certified Cloud PractitionerNouveau
Amazon Web Services · obtenue en octobre 2026
Vérifier la certificationCompétences et outils
- Languages
- Big Data
- Cloud & lakehouse
- Data modelling
- Orchestration
- Quality & DevOps
Formation
- Master 2, Données et Connaissances Université Paris-Saclay · Télécom ParisTech · 2016 – 2017
- Master 1, Génie Logiciel Université de Rennes 1 · 2015 – 2016
- Licence (Bac+3), Informatique Universidad de los Andes, Bogotá · 2007 – 2012
Langues
- Espagnol · C2
- Anglais · C1
- Français · C1
Ce site est rédigé dans les trois langues.
Au-delà de la data
Je suis ténor et je chante dès que je peux, je pratique le CrossFit et la nature me fascine, des rivières et des forêts jusqu'aux grands fonds marins.