En producción · Iniciado en julio 2026 · Actualizado el
Lakehouse de registros mercantiles europeos
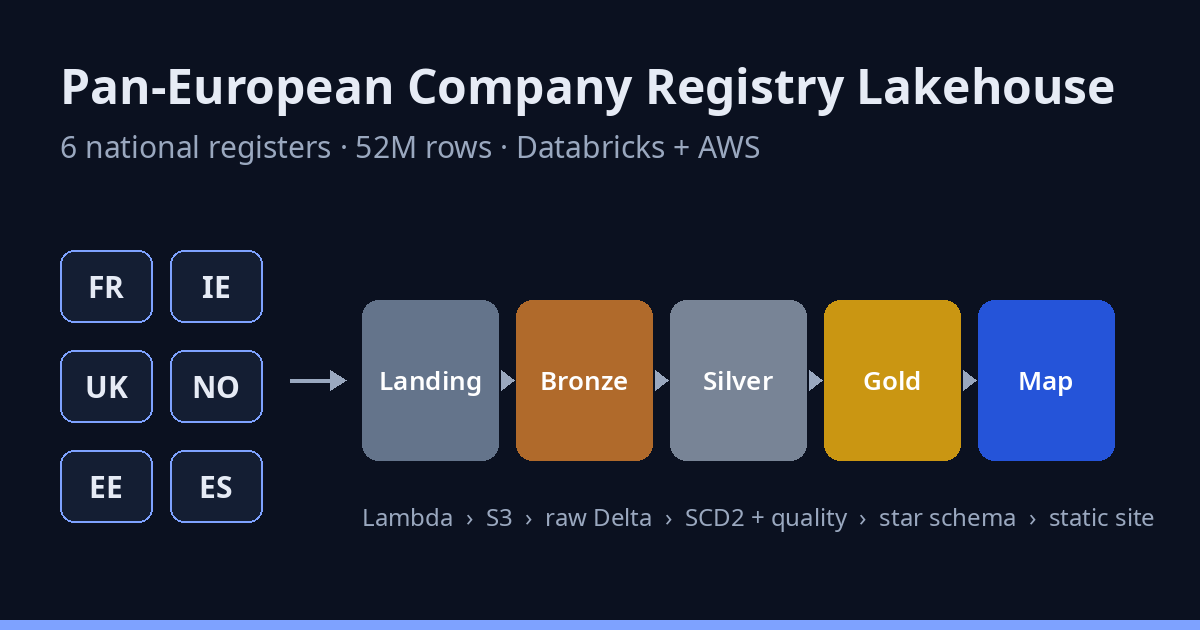
Seis registros mercantiles nacionales (52 millones de filas) ingeridos, limpiados, historizados y geocodificados sobre Databricks serverless y AWS, y publicados como un mapa interactivo y unos análisis que se actualizan cada mes.
En resumen
- 52 Mfilas de registro en las últimas instantáneas, de 6 países
- 97 %de las empresas vigentes en el mapa, sin coste
- ~200tests, todos ejecutables en un portátil
- 1tarea pequeña cuando nada cambia: los datos sin cambios casi no cuestan nada
El problema
La mayoría de los países europeos publican su registro mercantil como datos abiertos, y cada uno lo hace a su manera. Francia publica un CSV de 9 GB de establecimientos, el Reino Unido un CSV con cabeceras como CompanyNumber (con el espacio inicial incluido), Noruega un único array JSON de 2,8 GB con sangrías, Estonia un fichero delimitado por ; con marca de orden de bytes. Identificadores, fechas, códigos de actividad, estados y direcciones siguen convenciones nacionales.
El objetivo era un pipeline que convirtiera esos seis registros en un único modelo fiable, conservara su historia y respondiera preguntas que ninguno responde por separado: dónde están realmente las empresas, cuáles operan de verdad, dónde pesa la pesca, cuánto sobreviven las empresas nuevas. Tenía que funcionar solo cada mes, costar poco y poder probarse sin factura de la nube.
Fuentes de datos
| País | Registro | Formato | Granularidad | Filas |
|---|---|---|---|---|
| Francia | INSEE SIRENE, StockEtablissement | CSV, 9,3 GB | establecimiento | 44,3 M |
| Reino Unido | Companies House, Basic Company Data | CSV, 2,6 GB | persona jurídica | 5,7 M |
| Irlanda | Empresas de la CRO | CSV | persona jurídica | 0,8 M |
| Noruega | Brønnøysund, Enhetsregisteret | array JSON, 2,8 GB | persona jurídica | 1,2 M |
| Estonia | RIK, datos básicos del registro mercantil | CSV, ;, BOM |
persona jurídica | 0,4 M |
| España | Establecimientos de Navarra, panel anual | CSV, 9 años en un fichero | establecimiento | 0,4 M |
Dos realidades de los datos, explícitas en lugar de ocultas. España no tiene un registro nacional descargable gratis de forma masiva, así que la parte española son los datos abiertos de Navarra. Francia y Navarra publican establecimientos (centros), los demás personas jurídicas. El modelo guarda la granularidad de cada fuente, y cada análisis indica qué registros puede usar y cuáles no.
Arquitectura
- IngestaLambdas programadas resuelven la URL vigente de cada registro, la vuelcan a S3 bajo
ingest_date=, omiten los ficheros sin cambios por SHA-256 y reescriben el array JSON noruego como NDJSON.AWS Lambda · EventBridge · S3 - BronzeComprobación de deriva de esquema contra un contrato y carga de todas las columnas como STRING con linaje. Solo anexado, una tabla por registro.PySpark · Delta Lake
- SilverParseo y limpieza por fuente hacia un modelo canónico, reglas de calidad y cuarentena, y un MERGE SCD tipo 2 por país e instantánea.PySpark · Delta MERGE
- GeoGeocodificación por niveles: coordenadas del registro, luego cruces por código postal, distrito y municipio con GeoNames, más un proceso en segundo plano con geocodificadores públicos gratuitos.Spark · Lambda
- GoldEstrella Kimball: dimensión empresa, dimensión sector, agregados para el mapa y siete tablas de análisis con cobertura por país explícita.PySpark · Delta Lake
- PublicaciónJSON y GeoJSON agregados y ligeros, escritos directamente en el bucket de esta web. La página de resultados los lee en el navegador.S3 · Leaflet
Cómo se conectan las piezas
Intervienen tres sistemas, y ninguno guarda los secretos de otro.
- GitHub guarda el código. Un push a
mainejecuta todos los tests, espera mi aprobación en un entornoproductiony despliega dos veces: la pila de ingesta en AWS con SAM y el job de Databricks como Asset Bundle. El acceso a AWS pasa por GitHub OIDC, un rol de corta duración que solo ese entorno puede asumir, así que no hay ninguna clave de AWS almacenada. Databricks se despliega como service principal mediante OAuth. - AWS guarda los datos. EventBridge programa las descargas (Francia el día 2, Reino Unido e Irlanda el 3, etc.), Lambda deposita los ficheros en S3 y CloudWatch alerta ante cualquier error de una Lambda.
- Databricks pone el cómputo. El job se ejecuta en serverless el día 6 de cada mes y solo accede a S3 a través de Unity Catalog: un rol IAM, una credencial de almacenamiento, una ubicación externa y un volumen. El nombre del bucket no aparece nunca en el código ni en el repositorio.
La última tarea escribe el JSON de la web en el mismo bucket que sirve este sitio, así que la página y sus datos comparten origen. El sitio no se vuelve a desplegar cuando hay datos nuevos, y nunca habla con AWS ni con Databricks en tiempo de ejecución.
Decisiones de arquitectura
Medallion con silver SCD2 y gold Kimball, no Data Vault. La primera versión de este proyecto era un modelo Data Vault 2.0, y lo sustituí a propósito. Data Vault compensa cuando muchos sistemas describen las mismas claves de negocio. Aquí ninguna clave se comparte: un SIRET y un número de empresa británico nunca designan la misma empresa, así que cada hub era una copia renombrada de la columna de identificador de un registro, y cada consulta se convertía en un join de cinco o seis tablas, con cada shuffle facturado en serverless. Los registros publican instantáneas completas, así que la historia es exactamente lo que produce un merge SCD tipo 2, y Delta ya aporta la trazabilidad (time travel, RESTORE, Change Data Feed). Conservé las ideas de Data Vault que valen la pena: claves hash, un hash_diff para detectar cambios, la fuente del registro y el linaje, y la historia en bruto de solo inserción en bronze.
Todo se carga como texto. Bronze guarda cada columna como STRING. Un valor erróneo nunca puede hacer fallar una carga, y silver siempre puede volver a ejecutarse con un parseo mejor.
Descargas fuera de Spark. La ingesta es Python normal en Lambda: resuelve URL que cambian cada mes, transfiere ficheros de varios gigabytes sin cargarlos en memoria y rechaza un fichero de menos de la mitad del tamaño del anterior (así es una descarga truncada). Spark solo arranca cuando hay datos que procesar.
Geocodificación gratuita y por niveles en lugar de una API de pago. La primera versión llamaba a AWS Location Service desde una pandas UDF, con un sleep dentro de los ejecutores. Con 52 millones de filas eso es caro y frágil. Ahora la mayoría de las empresas se sitúan mediante cruces con un nomenclátor sin conexión, en segundos, y la precisión mejora poco a poco en segundo plano (ver Geocodificación más abajo).
Publicación estática en lugar de un cuadro de mando embebido. QuickSight y los dashboards de Databricks necesitan autenticación, configuración de embebido y un coste por visitante. Una página pública de portfolio no necesita nada de eso. El pipeline solo exporta agregados, así que ni datos fila a fila ni nombres salen nunca del lakehouse.
Pagar solo por lo que cambia. La primera tarea del job compara los ficheros de landing más recientes, el nomenclátor y los resultados de geocodificación con lo último procesado. Si nada cambió, una tarea condicional termina ahí la ejecución. Si solo cambió Francia, solo Francia pasa por bronze y silver. Cada etapa también se omite cuando sus entradas no cambian, y un test comprueba que volver a ejecutar sobre los mismos ficheros no escribe ninguna versión nueva de tabla ni ningún fichero publicado.
Primero en local. Todo el pipeline funciona en un portátil con PySpark 4 y Delta 4, las mismas versiones que serverless, sobre datos sintéticos que reproducen cada peculiaridad de los ficheros reales. Databricks solo se usa para el volumen de producción.
De los ficheros en bruto a tablas fiables: los retos
Ingesta
- Objetivos móviles. data.gouv.fr y los portales CKAN publican una URL nueva en cada edición. Cada registro tiene una pequeña petición JSON con un resolver (
static,template,datagouv,ckan), así que la Lambda encuentra sola el fichero vigente. - Un fichero que no se puede dividir. El registro noruego es un único array JSON de 2,8 GB. Spark lo leería en una sola tarea. La Lambda lo transforma en partes NDJSON comprimidas mientras lo descarga, y elimina por el camino los campos de e-mail, teléfono y web.
- Dos sistemas de notificación en un mismo bucket. El geocodificador se activaba al principio con eventos de S3, y el primer despliegue en producción falló: los file events de Databricks ya tenían una regla de notificación de S3 sobre el mismo prefijo, y S3 rechaza reglas que se solapan. Ahora el proceso hace un barrido diario de los ficheros de petición que aún no tienen resultado, lo que además reintenta los pendientes.
Bronze
Antes de leer un fichero, su cabecera (o, en NDJSON, su conjunto de claves) se compara con un contrato en sources.yml. Las columnas reordenadas se registran, las añadidas se permiten o detienen la ejecución según la política de la fuente, y las eliminadas o renombradas siempre la detienen, con una sugerencia de renombrado (codePostalEtablissement → codePostalEtablissment?). Las líneas CSV mal formadas van a _corrupt_record en lugar de desplazar todas las columnas siguientes.
Limpieza
Cada regla de limpieza viene de algo que encontré al perfilar los ficheros reales, y cada una está fijada por un test. Algunos ejemplos:
| Registro | Qué contiene el fichero | Qué hace el pipeline |
|---|---|---|
| Irlanda | NACE guardado como decimal: 311.0 |
Entero completado con ceros a la izquierda hasta cuatro cifras: 03.11, pesca marina. Sin el relleno se lee como 31.1, muebles. |
| Navarra | CNAE 4782.0 en 2021, 4782 en 2022 |
Normalizado antes del hash. Si no, cada establecimiento recibe una versión SCD2 nueva falsa. |
| Navarra | Mojibake de 2022 a 2024: TravesÃa |
Reparación Latin-1 → UTF-8 protegida, aplicada solo donde la conversión no puede fallar. |
| Navarra | Sin identificador de establecimiento, y la grafía de la calle cambia entre años | Clave construida con el NIF, el municipio y la calle reducida a sus letras significativas. |
| Francia | [ND] en cualquier campo (persona que se opuso a la publicación) |
Tratada como persona física: sin nombre, sin calle, sin coordenadas. |
| Francia | 1900-01-01 con el significado de "desconocida" |
Fecha centinela → NULL. |
| Reino Unido | SIC como texto: 03110 - Marine fishing, None Supplied |
Código de cinco cifras → clase NACE, marcadores → NULL. |
| Irlanda | ********NO ADDRESS DETAILS******* |
Centinela → NULL. Municipio extraído de la última línea de la dirección en lugar de un DUBLIN fijo. |
| Estonia | La calle está en una columna distinta de la que su nombre sugiere | Columna correcta mapeada, distrito agregado a la ciudad. |
| Noruega | Estado repartido entre indicadores booleanos y una fecha de baja | Un único estado derivado con una precedencia explícita. |
El parseo es seguro en modo ANSI. Serverless se ejecuta con ANSI activado, donde un cast o un to_date normal falla en la primera fila incorrecta y tumba el job. El código usa try_to_timestamp, try_cast y expresiones protegidas, y un pequeño linter de PySpark que escribí para el proyecto hace fallar la CI con las variantes que lanzan excepciones, con las UDF de Python, collect(), cache() (no soportado en serverless) y otros patrones que funcionan en local pero fallan o cuestan dinero en producción.
Los identificadores se validan con sus propios algoritmos de dígito de control como expresiones nativas de Spark: Luhn para SIREN y SIRET (con la regla especial de La Poste), módulo 11 para los números de organización noruegos, el módulo 11 en dos pasadas para los códigos de registro estonios. Tests basados en propiedades comparan cada uno con una implementación en Python puro.
Silver: controles de calidad e historia
Cada fila pasa por un motor de reglas en una sola pasada. Un aviso conserva la fila y se contabiliza. Un error la envía a silver.quarantine con las reglas incumplidas y el registro completo en JSON. Cada regla puede llevar además un umbral de parada: si de repente el 1 % de los identificadores falla su dígito de control, el problema es estructural (columnas desplazadas), así que la ejecución se detiene en lugar de cargar basura. Una instantánea con menos del 80 % de las filas de la anterior también detiene la ejecución.
La historia es un MERGE de Delta por país e instantánea. Las empresas que cambian tienen que cerrarse y volver a insertarse, así que se preparan dos veces, una con una clave de merge NULL:
(target.alias("t")
    .merge(staged.alias("s"),
           f"t.country_code = '{country}' AND t.is_current AND t.company_key = s._merge_key")
    .whenMatchedUpdate(condition="t.hash_diff <> s.hash_diff", set=close)      # cambió: cierra la versión anterior
    .whenNotMatchedInsert(values=insert_values)                                 # empresa nueva o versión nueva
    .whenNotMatchedBySourceUpdate(condition=f"t.country_code = '{country}' AND t.is_current",
                                  set=close)                                    # salió del registro
    .execute())
La tabla impone sus propias invariantes con restricciones CHECK (países y estados conocidos, valid_to >= valid_from, filas vigentes abiertas, códigos NACE bien formados), así que una regresión en el código no puede escribir un estado inválido. Usa liquid clustering por país y sector, y el cargador rechaza instantáneas anteriores a la última cargada e indica que se use RESTORE.
Geocodificación
Las empresas se sitúan en el nivel más preciso disponible, y cada candidato se comprueba contra el recuadro del país:
- Dirección, a partir de las coordenadas del registro. El INSEE publica coordenadas Lambert-93 para unos dos tercios de los establecimientos franceses. La proyección a latitud y longitud está escrita con expresiones nativas de Spark y verificada contra PROJ al centímetro.
- Código postal, distrito y municipio, mediante cruces con el nomenclátor GeoNames: códigos postales británicos completos, su parte de zona, claves de encaminamiento del Eircode irlandés, centroides de municipios.
- Dirección, poco a poco. Cada ejecución exporta hasta 700 de las ubicaciones aproximadas más valiosas, primero las empresas pesqueras. Una Lambda las geocodifica con servicios públicos gratuitos (Kartverket para Noruega, Maa-amet para Estonia, IGN CartoCiudad para España, Nominatim a una petición por segundo en el resto) y valida cada resultado contra el recuadro del país y, cuando es posible, el código postal del registro. La siguiente ejecución integra los resultados en una caché de solo inserción, así que nada se geocodifica dos veces.
Resultado: el 97 % de las empresas vigentes está en el mapa, sin factura de geocodificación.
Gold: respuestas que reconocen lo que no saben
Gold es una estrella Kimball (dim_company, dim_industry, agregados para el mapa) más siete tablas de análisis. Lo difícil no fue el SQL, sino saber qué puede sostener honestamente cada registro. Los ficheros masivos del Reino Unido, Noruega y Estonia solo listan empresas vivas, así que sus años antiguos están infravalorados y no permiten medir la supervivencia. Una tabla gold.insight_coverage indica qué países incluye o excluye cada análisis, con el motivo, para que un dato desconocido nunca aparezca como cero.
Lo que me enseñó la primera ejecución en producción
Los tests locales detectaron mucho, pero producción encontró cinco problemas más, cada uno cubierto ahora por un test:
- Tareas en paralelo creaban las mismas tablas a la vez. La creación de tablas es ahora idempotente, y el bucle de silver procesa los países de uno en uno, ya que todos hacen merge sobre la misma tabla.
- En Spark Connect, leer una ruta inexistente funciona y solo falla al recuperar filas, así que un
tryalrededor deload()nunca saltaba. Ahora las comprobaciones son inmediatas. - El panel de 2020 de Navarra no tiene municipio. Una regla de calidad impidió cargar ese año. La clave ya no usa el municipio, y el municipio se rellena a partir de los demás años del mismo establecimiento.
DESCRIBE HISTORYinterpreta mal una columna llamadalocation, así que el historial de tablas se lee mediante la API de Delta.- La confianza OIDC falló en el primer despliegue: los repositorios con sujetos OIDC inmutables envían
repo:<owner>@<id>/<repo>@<id>, norepo:<owner>/<repo>.
Qué muestran los datos
Los resultados completos, con el mapa interactivo y todos los gráficos, están en la página de resultados. Lee los ficheros que publicó el pipeline en su última ejecución.
- Una empresa registrada no es una empresa en actividad. En el Reino Unido solo alrededor del 59 % de las empresas activas parece operar donde está registrado. El 27 % está en una dirección compartida por 50 empresas o más, y una dirección de Londres alberga más de 76.000. Sin esta corrección, un mapa de empresas muestra sobre todo dónde están los despachos que constituyen sociedades.
- Los polos pesqueros aparecen al normalizar las cifras. El cociente de localización destaca Shetland, Orcadas, las Hébridas y el noreste de Escocia, y en Francia la costa ostrícola y mejillonera de Charente-Maritime, la bahía del Mont-Saint-Michel y la laguna de Thau.
- Supervivencia. De los establecimientos franceses creados en 2016, alrededor del 38 % seguía abierto diez años después, con grandes diferencias entre sectores.
- Los datos tienen forma. Cada registro necesitó sus propias correcciones, y el informe de calidad muestra lo que queda: la mayoría de las empresas irlandesas no tiene un código postal válido, y unos pocos miles de números de empresa británicos no encajan en ningún formato conocido y esperan en cuarentena.
Operación, coste y privacidad
- Orquestación. Un único job de Databricks con un control de cambios, tareas for-each por país, timeouts por tarea, una alerta de duración antes del timeout, alertas por e-mail y
max_concurrent_runs: 1. Silver nunca reintenta: un fallo de calidad debe detener la ejecución, no repetirla. - Coste. Serverless en modo optimizado en coste, entradas sin cambios omitidas en todos los niveles, sin UDF de Python, sin API de geocodificación dentro de Spark. Un pequeño estimador predice las DBU de una ejecución a partir del tamaño de las entradas, y una tarea
cost_reportregistra el coste real de cada ejecución desdesystem.billing, para poder calibrar la estimación. - Privacidad. El repositorio es público, así que no contiene datos reales: los datos de prueba son sintéticos, generados a partir de la forma de los ficheros reales con identificadores nuevos que siguen superando sus dígitos de control. Hooks de pre-commit y la CI buscan secretos e identificadores de infraestructura. En el lakehouse, las personas físicas no conservan nombre ni calle, y los NIF personales españoles se sustituyen por un hash con clave.
- Tests. Unos 200: parsers (incluidos tests basados en propiedades), un test por registro que fija sus decisiones de limpieza, el ciclo de vida e idempotencia del SCD2, el motor de calidad, la geocodificación, las Lambdas, comprobaciones de planes de consulta (sin UDF, sin producto cartesiano, tamaño de plan acotado) y una ejecución completa de principio a fin con los seis registros.
Próximos pasos
- Más campos. Los códigos de actividad de Estonia y las formas jurídicas y nombres de empresa franceses están en ficheros separados (RIK EMTAK e INSEE StockUniteLegale). El registro noruego de centros de trabajo situaría los empleos pesqueros en el lugar real en vez de en la sede.
- Calibrar el modelo de coste con los primeros meses de datos de
system.billing. - Grupos transfronterizos. Relacionar un mismo grupo entre registros requeriría emparejamiento aproximado de nombres y direcciones. El modelo silver deja sitio para una tabla de enlace sin rehacer el modelo.