En production · Démarré en juillet 2026 · Mis à jour le
Lakehouse des registres d'entreprises européens
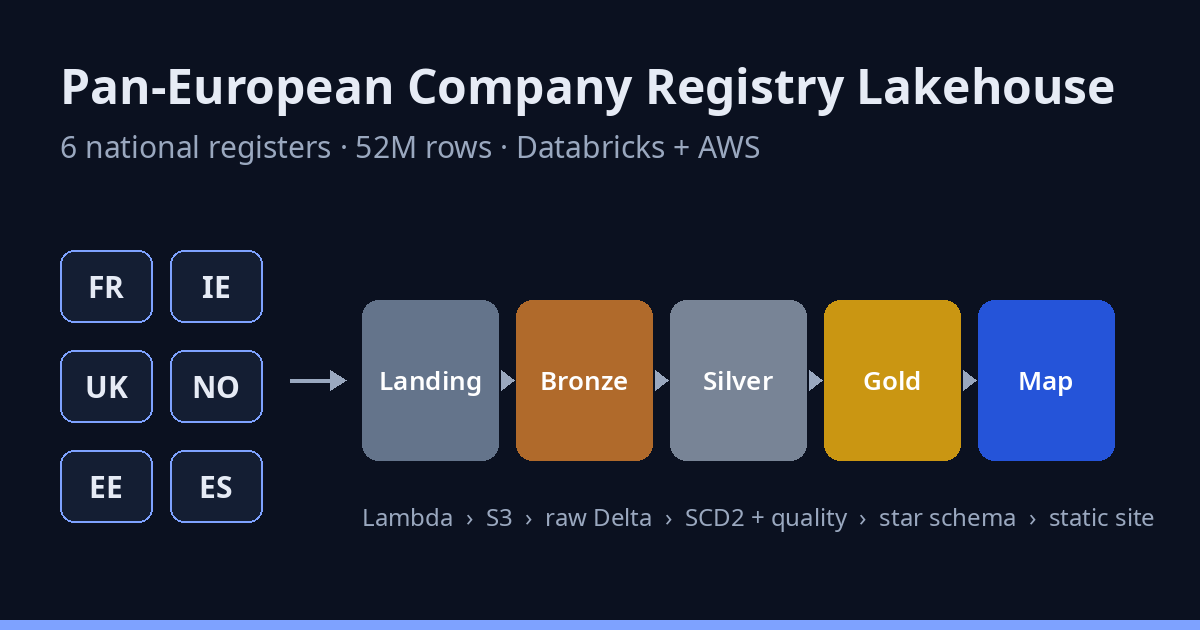
Six registres nationaux d'entreprises (52 millions de lignes) ingérés, nettoyés, historisés et géocodés sur Databricks serverless et AWS, puis publiés sous forme de carte interactive et d'analyses mises à jour chaque mois.
En bref
- 52 Mlignes de registre dans les derniers instantanés, de 6 pays
- 97 %des entreprises courantes placées sur la carte, gratuitement
- ~200tests, tous exécutables sur un portable
- 1petite tâche quand rien n'a changé : des données inchangées ne coûtent presque rien
Le problème
La plupart des pays européens publient leur registre d'entreprises en open data, et chacun à sa manière. La France publie un CSV de 9 Go d'établissements, le Royaume-Uni un CSV aux en-têtes comme CompanyNumber (espace initial compris), la Norvège un unique tableau JSON indenté de 2,8 Go, l'Estonie un fichier délimité par ; avec une marque d'ordre des octets. Identifiants, dates, codes d'activité, statuts et adresses suivent tous des conventions nationales.
L'objectif était un pipeline qui transforme ces six registres en un modèle fiable, conserve leur historique et réponde à des questions qu'aucun ne résout seul : où sont vraiment les entreprises, lesquelles exercent réellement, où la pêche compte, combien de temps survivent les entreprises nouvelles. Il devait tourner seul chaque mois, coûter peu et pouvoir être testé sans facture cloud.
Sources de données
| Pays | Registre | Format | Granularité | Lignes |
|---|---|---|---|---|
| France | INSEE SIRENE, StockEtablissement | CSV, 9,3 Go | établissement | 44,3 M |
| Royaume-Uni | Companies House, Basic Company Data | CSV, 2,6 Go | personne morale | 5,7 M |
| Irlande | Sociétés du CRO | CSV | personne morale | 0,8 M |
| Norvège | Brønnøysund, Enhetsregisteret | tableau JSON, 2,8 Go | personne morale | 1,2 M |
| Estonie | RIK, données de base du registre du commerce | CSV, ;, BOM |
personne morale | 0,4 M |
| Espagne | Établissements de Navarre, panel annuel | CSV, 9 ans dans un fichier | établissement | 0,4 M |
Deux réalités des données, rendues explicites plutôt que cachées. L'Espagne n'a pas de registre national téléchargeable gratuitement en masse : la partie espagnole vient donc de l'open data régional de Navarre. La France et la Navarre publient des établissements (sites), les autres des personnes morales. Le modèle garde la granularité de chaque source, et chaque analyse indique quels registres elle peut utiliser ou non.
Architecture
- IngestionDes Lambdas planifiées résolvent l'URL courante de chaque registre, la versent dans S3 sous
ingest_date=, ignorent les fichiers inchangés grâce au SHA-256 et réécrivent le tableau JSON norvégien en NDJSON.AWS Lambda · EventBridge · S3 - BronzeContrôle de dérive de schéma par rapport à un contrat, puis chargement de chaque colonne en STRING avec son lignage. En ajout seul, une table par registre.PySpark · Delta Lake
- SilverParsing et nettoyage par source vers un modèle canonique, règles qualité et quarantaine, puis un MERGE SCD de type 2 par pays et par instantané.PySpark · Delta MERGE
- GéoGéocodage par niveaux : coordonnées du registre, puis jointures par code postal, district et commune avec GeoNames, plus un processus en arrière-plan sur des géocodeurs publics gratuits.Spark · Lambda
- GoldÉtoile de Kimball : dimension entreprise, dimension secteur, agrégats pour la carte et sept tables d'analyse avec une couverture par pays explicite.PySpark · Delta Lake
- PublicationDes JSON et GeoJSON agrégés et légers écrits directement dans le bucket de ce site. La page des résultats les lit dans le navigateur.S3 · Leaflet
Comment les pièces s'articulent
Trois systèmes interviennent, et aucun ne détient les secrets d'un autre.
- GitHub détient le code. Un push sur
mainlance toute la suite de tests, attend ma validation dans un environnementproduction, puis déploie deux fois : la pile d'ingestion sur AWS avec SAM, et le job Databricks en Asset Bundle. L'accès à AWS passe par GitHub OIDC, un rôle de courte durée que seul cet environnement peut assumer : aucune clé AWS n'est stockée nulle part. Databricks est déployé en service principal via OAuth. - AWS détient les données. EventBridge planifie les téléchargements (la France le 2, le Royaume-Uni et l'Irlande le 3, etc.), Lambda dépose les fichiers dans S3 et CloudWatch alerte à la moindre erreur d'une Lambda.
- Databricks fournit le calcul. Le job tourne en serverless le 6 de chaque mois et n'accède à S3 que via Unity Catalog : un rôle IAM, une storage credential, une external location et un volume. Le nom du bucket n'apparaît jamais dans le code ni dans le dépôt.
La dernière tâche écrit le JSON du site dans le bucket même qui sert ce site : la page et ses données partagent donc la même origine. Le site n'est jamais redéployé pour de nouvelles données, et il ne parle jamais à AWS ni à Databricks à l'exécution.
Choix d'architecture
Médaillon avec un silver SCD2 et un gold Kimball, pas Data Vault. La première version de ce projet était un modèle Data Vault 2.0, et je l'ai remplacé volontairement. Data Vault est rentable quand plusieurs systèmes décrivent les mêmes clés métier. Ici aucune clé n'est partagée : un SIRET et un numéro de société britannique ne désignent jamais la même entreprise, donc chaque hub n'était qu'une copie renommée de la colonne d'identifiant d'un registre, et chaque requête devenait une jointure à cinq ou six tables, chaque shuffle étant facturé en serverless. Les registres publient des instantanés complets : l'historique est exactement ce que produit un merge SCD de type 2, et Delta fournit déjà la traçabilité (time travel, RESTORE, Change Data Feed). J'ai gardé les idées de Data Vault qui en valent la peine : clés de hachage, un hash_diff pour détecter les changements, la source et le lignage des enregistrements, et l'historique brut en insertion seule dans bronze.
Tout arrive en texte. Bronze stocke chaque colonne en STRING. Une valeur erronée ne peut jamais faire échouer un chargement, et silver peut toujours être relancé avec un meilleur parsing.
Les téléchargements hors de Spark. L'ingestion est du Python simple dans Lambda : elle résout des URL qui changent chaque mois, transfère en flux des fichiers de plusieurs gigaoctets sans les garder en mémoire, et refuse un fichier de moins de la moitié de la taille du précédent (c'est à cela que ressemble un téléchargement tronqué). Spark ne démarre que s'il y a des données à traiter.
Un géocodage gratuit et par niveaux plutôt qu'une API payante. La première version appelait AWS Location Service depuis une pandas UDF, avec un sleep dans les exécuteurs. Sur 52 millions de lignes, c'est cher et fragile. Désormais la plupart des entreprises sont placées par jointure avec un référentiel géographique hors ligne, en quelques secondes, et la précision s'améliore progressivement en arrière-plan (voir Géocodage plus bas).
Une publication statique plutôt qu'un tableau de bord intégré. QuickSight et les dashboards Databricks exigent une authentification, une configuration d'intégration et un coût par visiteur. Une page publique de portfolio n'a besoin de rien de tout cela. Le pipeline n'exporte que des agrégats : aucune donnée ligne à ligne ni aucun nom ne sort du lakehouse.
Ne payer que ce qui change. La première tâche du job compare les fichiers de landing les plus récents, le référentiel géographique et les résultats de géocodage avec ce qui a été traité en dernier. Si rien n'a changé, une tâche conditionnelle arrête l'exécution. Si seule la France a changé, seule la France passe par bronze et silver. Chaque étape se saute aussi quand ses entrées n'ont pas changé, et un test vérifie qu'une relance sur les mêmes fichiers n'écrit aucune nouvelle version de table ni aucun fichier publié.
Le local d'abord. Tout le pipeline tourne sur un portable avec PySpark 4 et Delta 4, les mêmes versions qu'en serverless, sur des données synthétiques qui reproduisent chaque particularité des vrais fichiers. Databricks ne sert qu'au volume de production.
Des fichiers bruts aux tables fiables : les défis
Ingestion
- Des cibles mouvantes. data.gouv.fr et les portails CKAN publient une nouvelle URL à chaque édition. Chaque registre a une petite requête JSON avec un resolver (
static,template,datagouv,ckan) : la Lambda trouve seule le fichier courant. - Un fichier indivisible. Le registre norvégien est un unique tableau JSON de 2,8 Go. Spark le lirait en une seule tâche. La Lambda le découpe en parties NDJSON compressées pendant le téléchargement, et supprime au passage les champs e-mail, téléphone et site web.
- Deux systèmes de notification sur un même bucket. Le géocodeur était d'abord déclenché par des événements S3, et le premier déploiement en production a échoué : les file events de Databricks possédaient déjà une règle de notification S3 sur le même préfixe, et S3 refuse les règles qui se chevauchent. Le processus passe désormais une fois par jour sur les fichiers de requête sans résultat, ce qui relance aussi les restes.
Bronze
Avant de lire un fichier, son en-tête (ou, pour le NDJSON, son ensemble de clés) est comparé à un contrat dans sources.yml. Les colonnes réordonnées sont journalisées, les colonnes ajoutées sont acceptées ou bloquantes selon la politique de la source, et les colonnes supprimées ou renommées arrêtent toujours l'exécution, avec une suggestion de renommage (codePostalEtablissement → codePostalEtablissment?). Les lignes CSV mal formées vont dans _corrupt_record au lieu de décaler toutes les colonnes suivantes.
Nettoyage
Chaque règle de nettoyage vient d'un constat fait en profilant les vrais fichiers, et chacune est verrouillée par un test. Quelques exemples :
| Registre | Ce que contient le fichier | Ce que fait le pipeline |
|---|---|---|
| Irlande | NACE stocké en décimal : 311.0 |
Entier complété à gauche sur quatre chiffres : 03.11, pêche en mer. Sans ce complément, il se lit 31.1, fabrication de meubles. |
| Navarre | CNAE 4782.0 en 2021, 4782 en 2022 |
Normalisé avant le hachage. Sinon chaque établissement reçoit une fausse nouvelle version SCD2. |
| Navarre | Mojibake de 2022 à 2024 : TravesÃa |
Réparation Latin-1 → UTF-8 protégée, appliquée seulement là où la conversion ne peut pas échouer. |
| Navarre | Pas d'identifiant d'établissement, et l'orthographe de la rue varie d'une année à l'autre | Clé construite avec le numéro fiscal, la commune et la rue réduite à ses lettres significatives. |
| France | [ND] dans n'importe quel champ (personne opposée à la diffusion) |
Traité comme une personne physique : pas de nom, pas de rue, pas de coordonnées. |
| France | 1900-01-01 pour « inconnue » |
Date sentinelle → NULL. |
| Royaume-Uni | SIC en texte : 03110 - Marine fishing, None Supplied |
Code à cinq chiffres → classe NACE, valeurs factices → NULL. |
| Irlande | ********NO ADDRESS DETAILS******* |
Sentinelle → NULL. Commune extraite de la dernière ligne d'adresse au lieu d'un DUBLIN codé en dur. |
| Estonie | La rue est dans une autre colonne que celle que son nom suggère | Bonne colonne mappée, district ramené à la ville. |
| Norvège | Statut réparti entre des indicateurs booléens et une date de suppression | Un seul statut dérivé, avec un ordre de priorité explicite. |
Le parsing est compatible ANSI. Le serverless tourne avec le mode ANSI activé, où un simple cast ou to_date lève une exception à la première ligne invalide et fait tomber le job. Le code utilise try_to_timestamp, try_cast et des expressions protégées, et un petit linter PySpark écrit pour le projet fait échouer la CI sur les variantes qui lèvent des exceptions, sur les UDF Python, collect(), cache() (non pris en charge en serverless) et d'autres motifs qui marchent en local mais échouent ou coûtent cher en production.
Les identifiants sont validés par leurs propres algorithmes de clé de contrôle, en expressions Spark natives : Luhn pour le SIREN et le SIRET (avec la règle spéciale de La Poste), modulo 11 pour les numéros d'organisation norvégiens, le modulo 11 en deux passes pour les codes du registre estonien. Des tests par propriétés comparent chacun à une implémentation en Python pur.
Silver : contrôles qualité et historique
Chaque ligne passe par un moteur de règles en une seule passe. Un avertissement conserve la ligne et la compte. Une erreur l'envoie dans silver.quarantine avec les règles en échec et l'enregistrement complet en JSON. Chaque règle peut aussi porter un seuil d'arrêt : si soudain 1 % des identifiants échouent à leur clé de contrôle, le problème est structurel (colonnes décalées), donc l'exécution s'arrête au lieu de charger des données fausses. Un instantané de moins de 80 % du nombre de lignes du précédent arrête aussi l'exécution.
L'historique, c'est un MERGE Delta par pays et par instantané. Les entreprises modifiées doivent être à la fois fermées et réinsérées : elles sont donc préparées deux fois, dont une avec une clé de merge NULL :
(target.alias("t")
    .merge(staged.alias("s"),
           f"t.country_code = '{country}' AND t.is_current AND t.company_key = s._merge_key")
    .whenMatchedUpdate(condition="t.hash_diff <> s.hash_diff", set=close)      # modifiée : ferme l'ancienne version
    .whenNotMatchedInsert(values=insert_values)                                 # nouvelle entreprise ou nouvelle version
    .whenNotMatchedBySourceUpdate(condition=f"t.country_code = '{country}' AND t.is_current",
                                  set=close)                                    # sortie du registre
    .execute())
La table impose ses propres invariants par des contraintes CHECK (pays et statuts connus, valid_to >= valid_from, lignes courantes ouvertes, codes NACE bien formés) : une régression du code ne peut pas écrire un état invalide. Elle utilise le liquid clustering par pays et secteur, et le chargeur refuse un instantané plus ancien que le dernier chargé en renvoyant vers RESTORE.
Géocodage
Les entreprises sont placées au niveau le plus précis disponible, et chaque candidat est vérifié par rapport à l'emprise du pays :
- Adresse, à partir des coordonnées du registre. L'INSEE publie des coordonnées Lambert-93 pour environ deux tiers des établissements français. La projection en latitude et longitude est écrite en expressions Spark natives et vérifiée par rapport à PROJ au centimètre près.
- Code postal, district et commune, par jointure avec le référentiel GeoNames : codes postaux britanniques complets, leur partie de zone, clés de routage de l'Eircode irlandais, centroïdes des communes.
- Adresse, progressivement. Chaque exécution exporte jusqu'à 700 des localisations approximatives les plus utiles, entreprises de pêche en premier. Une Lambda les géocode avec des services publics gratuits (Kartverket pour la Norvège, Maa-amet pour l'Estonie, IGN CartoCiudad pour l'Espagne, Nominatim à une requête par seconde ailleurs) et valide chaque résultat par l'emprise du pays et, quand c'est possible, par le code postal du registre. L'exécution suivante intègre les résultats dans un cache en insertion seule : rien n'est géocodé deux fois.
Résultat : 97 % des entreprises courantes sont sur la carte, sans facture de géocodage.
Gold : des réponses qui reconnaissent ce qu'elles ignorent
Gold est une étoile de Kimball (dim_company, dim_industry, agrégats pour la carte) plus sept tables d'analyse. Le plus difficile n'était pas le SQL, mais savoir ce que chaque registre permet honnêtement d'affirmer. Les fichiers complets du Royaume-Uni, de la Norvège et de l'Estonie ne listent que les entreprises vivantes : leurs années anciennes sont sous-estimées et ne permettent pas de mesurer la survie. Une table gold.insight_coverage liste les pays inclus ou exclus de chaque analyse, avec la raison, pour qu'une valeur inconnue ne soit jamais affichée comme zéro.
Ce que m'a appris la première exécution en production
Les tests locaux ont détecté beaucoup de choses, mais la production a trouvé cinq problèmes de plus, chacun désormais couvert par un test :
- Des tâches parallèles créaient les mêmes tables en même temps. La création de tables est désormais idempotente, et la boucle silver traite un pays à la fois, puisque tous fusionnent dans la même table.
- Sur Spark Connect, lire un chemin inexistant réussit et n'échoue qu'à la récupération des lignes : un
tryautour deload()ne se déclenchait donc jamais. Les contrôles sont maintenant immédiats. - Le panel 2020 de Navarre n'a aucune commune. Une règle qualité a bloqué le chargement de cette année. La clé n'utilise plus la commune, et celle-ci est complétée à partir des autres années du même établissement.
DESCRIBE HISTORYinterprète mal une colonne nomméelocation: l'historique des tables est donc lu via l'API Delta.- La confiance OIDC a échoué au premier déploiement : les dépôts à sujets OIDC immuables envoient
repo:<owner>@<id>/<repo>@<id>, et nonrepo:<owner>/<repo>.
Ce que montrent les données
Les résultats complets, avec la carte interactive et tous les graphiques, sont sur la page des résultats. Elle lit les fichiers publiés par le pipeline lors de sa dernière exécution.
- Une entreprise immatriculée n'est pas une entreprise en activité. Au Royaume-Uni, seules 59 % environ des entreprises actives semblent exercer là où elles sont immatriculées. 27 % sont à une adresse partagée par 50 entreprises ou plus, et une seule adresse londonienne en héberge plus de 76 000. Sans cette correction, une carte des entreprises montre surtout où sont les domiciliataires.
- Les pôles de pêche apparaissent une fois les chiffres normalisés. Le quotient de localisation fait ressortir les Shetland, les Orcades, les Hébrides et le nord-est de l'Écosse, et en France la côte ostréicole et mytilicole de Charente-Maritime, la baie du Mont-Saint-Michel et l'étang de Thau.
- Survie. Parmi les établissements français créés en 2016, environ 38 % étaient encore ouverts dix ans plus tard, avec de grandes différences selon les secteurs.
- Les données ont une forme. Chaque registre a demandé ses propres corrections, et le rapport qualité montre ce qui reste : la plupart des sociétés irlandaises n'ont pas de code postal valide, et quelques milliers de numéros de société britanniques ne correspondent à aucun format connu et attendent en quarantaine.
Exploitation, coût et confidentialité
- Orchestration. Un seul job Databricks avec un contrôle des changements, des tâches for-each par pays, des timeouts par tâche, une alerte de durée avant le timeout, des alertes e-mail et
max_concurrent_runs: 1. Silver ne relance jamais : un échec qualité doit arrêter l'exécution, pas la répéter. - Coût. Serverless en mode optimisé pour le coût, entrées inchangées ignorées à tous les niveaux, pas d'UDF Python, pas d'API de géocodage dans Spark. Un petit estimateur prédit les DBU d'une exécution à partir de la taille des entrées, et une tâche
cost_reportenregistre le coût réel de chaque exécution depuissystem.billing, pour pouvoir calibrer l'estimation. - Confidentialité. Le dépôt est public, il ne contient donc aucune donnée réelle : les jeux de test sont synthétiques, générés à partir de la forme des vrais fichiers avec de nouveaux identifiants qui passent toujours leur clé de contrôle. Des hooks pre-commit et la CI recherchent secrets et identifiants d'infrastructure. Dans le lakehouse, les personnes physiques ne gardent ni nom ni rue, et les numéros fiscaux personnels espagnols sont remplacés par un hachage à clé.
- Tests. Environ 200 : parsers (dont des tests par propriétés), un test par registre qui verrouille ses choix de nettoyage, cycle de vie et idempotence du SCD2, moteur qualité, géocodage, Lambdas, vérifications des plans de requête (pas d'UDF, pas de produit cartésien, taille de plan bornée) et une exécution complète de bout en bout sur les six registres.
Prochaines étapes
- Plus de champs. Les codes d'activité estoniens, ainsi que les formes juridiques et les noms des entreprises françaises, sont dans des fichiers séparés (RIK EMTAK et INSEE StockUniteLegale). Le registre norvégien des lieux de travail placerait les emplois de la pêche sur le site réel plutôt qu'au siège.
- Calibrer le modèle de coût avec les premiers mois de données de
system.billing. - Groupes transfrontaliers. Rapprocher un même groupe entre registres demanderait un appariement approximatif des noms et des adresses. Le modèle silver laisse la place à une table de liens sans remodélisation.