Data Engineer · PySpark · Databricks · AWS

Bonjour, je suis Cato. Je construis des pipelines qui transforment des sources désordonnées en tables fiables.

Data engineer avec plus de 6 ans d'expérience dans la construction de pipelines d'intégration de données pour la finance, l'assurance, la mobilité et le marketing, de Spark sur Hadoop à Azure Data Factory et BigQuery. Mon dernier projet est un lakehouse des registres d'entreprises européens sur Databricks et AWS : il tient à jour 52 millions de lignes de registre chaque mois, et ses résultats sont en ligne sur ce site.

Ouvert aux postes de data engineer : CDI ou freelance, en télétravail ou sur site en Europe.

Expérience avec

  • Corum L'Épargne
  • RiverBank
  • Epsilon France (Publicis Groupe)
  • Mobilize Financial Services
  • PMU
  • Allianz France
Cato Perez

AWS Certified Cloud PractitionerNouveau

Amazon Web Services · obtenue en octobre 2026

Vérifier la certification
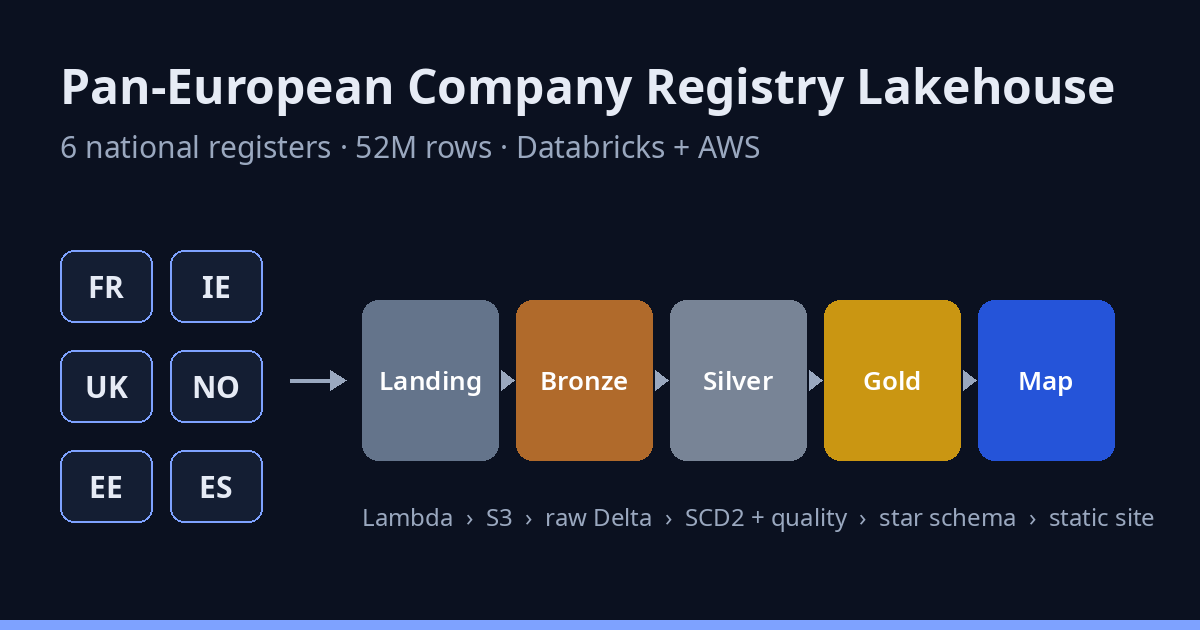
Six registres nationaux qui traversent les couches landing, bronze, silver et gold jusqu'à une carte

En production · Mis à jour le 15 octobre 2026

Lakehouse des registres d'entreprises européens

Six registres nationaux d'entreprises (52 millions de lignes) ingérés, nettoyés, historisés et géocodés sur Databricks serverless et AWS, puis publiés sous forme de carte interactive et d'analyses mises à jour chaque mois.

  • 52 Mlignes de registre, mises à jour chaque mois
  • 6registres nationaux, un seul modèle harmonisé
  • 97 %des entreprises sur la carte, avec un géocodage gratuit
  • ~200tests, tous exécutables sur un portable
Ce qu'il contient
  • Ingestion avec AWS Lambda et S3, planifiée par EventBridge et déployée avec SAM via GitHub OIDC.
  • Architecture médaillon sur Databricks serverless : bronze brut, silver SCD de type 2 avec un MERGE Delta par instantané, gold Kimball.
  • Moteur de qualité des données avec quarantaine et seuils d'arrêt, contrats de dérive de schéma, parsing compatible ANSI des particularités de chaque registre.
  • Géocodage par niveaux avec des jointures hors ligne et des géocodeurs publics gratuits, au lieu d'une API payante.
  • Détection des changements : un mois sans changement coûte une seule petite tâche. CI/CD avec tests, validation et déploiements en service principal.
  • Résultats publiés en JSON statique : une carte en direct et des analyses sur les entreprises en activité, les pôles de pêche et la survie des entreprises.

Sur quoi je travaille

  • En production Un lakehouse qui nettoie, historise et géocode chaque mois six registres d'entreprises européens sur Databricks serverless et AWS, avec une carte des résultats en direct.
  • Certifié AWS Certified Cloud Practitioner, obtenue en octobre 2026. En production dans mon lakehouse : Lambda, S3, IAM, EventBridge, CloudWatch et SAM.
  • Rédaction Des fiches d'étude question par question sur AWS, PySpark, Python, PostgreSQL et dbt.

Compétences et outils

Languages
  • Python
  • SQL
  • Scala
Big Data
  • Apache Spark
  • PySpark
  • Hadoop
  • Hive
  • Apache NiFi
Cloud & lakehouse
  • Databricks
  • Delta Lake
  • AWS
  • Google BigQuery
  • Azure Data Factory
Data modelling
  • Data Vault 2.0
  • Medallion architecture
  • Dimensional modelling
  • PostgreSQL
Orchestration
  • Apache Airflow
  • Control-M
  • Azure Data Factory
  • AWS Lambda
Quality & DevOps
  • pytest
  • ScalaTest
  • Docker
  • Git
  • GitLab

Parlons data

Vous recrutez un data engineer ou souhaitez échanger sur un pipeline ? Je serai ravi de vous lire.

Me contacter